第 9 章:学习与适应
学习与适应是提升 AI 智能体能力的关键所在。这两个过程使智能体得以突破预设的参数限制,经由经验积累与环境互动自主成长,从而有效应对新情境、持续优化表现,而无需人工持续干预。本章将深入阐述支撑智能体学习与适应的原理与机制。
全景
智能体通过基于新经验与新数据调整思维方式、行为策略或知识结构,实现学习与适应,并由此从单纯执行指令逐步演进为能随时间持续变得更智能的系统。
- 强化学习: 尝试动作,对好结果得奖励、坏结果受惩罚,在变化情境中学习最优行为;适用于控制机器人或玩游戏等智能体。
- 监督学习: 从标注样本学习输入到期望输出的映射,支持决策与模式识别等;适合分拣邮件或预测趋势的智能体。
- 无监督学习: 从未标注数据中发现隐含关联与模式,辅助洞察、组织信息与构建环境心智图谱;适合无特定指引下探索数据的智能体。
- 基于 LLM 的少样本/零样本学习: 借助 LLM,用极少示例或清晰指令快速适应新任务与新情境。
- 在线学习: 持续用新数据更新知识,对实时反应与动态环境中的持续适应至关重要;适合处理连续数据流的智能体。
- 基于记忆的学习: 回忆过去经验以在相似情境下调整当前行为,增强情境感知与决策;适合具备记忆召回能力的智能体。
智能体还会因学习而改变策略、理解或目标,这在不可预测、变化或全新的环境中至关重要。
近端策略优化(PPO) 是一种强化学习算法,适用于动作空间连续的场景(例如控制机器人关节或游戏角色);其主旨是在可靠、稳定的前提下改进智能体的决策策略。
PPO 的核心在于对策略做小幅、稳健的更新,避免剧烈变化导致性能崩溃。其工作方式如下:
- 收集数据: 智能体以当前策略与环境交互(如玩游戏),收集一批经验样本(状态、动作、奖励)。
- 评估替代目标(surrogate): PPO 估算一次策略更新会如何改变期望奖励;但并非直接最大化该量,而是采用带「裁剪」的替代目标函数来约束更新幅度。
- 裁剪机制: 这是 PPO 稳定性的关键:在当前策略周围划定「信任域」或安全区,禁止更新与现行策略偏离过大;裁剪机制如同安全刹车,避免智能体迈出过大、冒险的一步,使已有学习成果前功尽弃。
简言之,PPO 在提升性能与保持在已知有效策略附近之间取得平衡,从而减少训练中的灾难性失败,使学习过程更加稳定。
直接偏好优化(DPO) 是一种较新的方法,专用于将大语言模型与人类偏好对齐;相对用 PPO 完成该任务,它更简单、更直接。
要理解 DPO,不妨先了解传统的基于 PPO 的对齐方法:
- PPO 路径(两步):
- 训练奖励模型: 收集人类对不同回复的评分或比较数据(如「A 比 B 好」),训练单独的奖励模型,预测人类会给新回复打多少分。
- 用 PPO 微调: 再用 PPO 微调 LLM,使其生成在奖励模型看来得分最高的回复;奖励模型在训练中充当「裁判」。
两步流程可能既复杂又不稳定:例如 LLM 可能利用奖励模型的漏洞,让质量欠佳的回复仍获得较高评分。
- DPO 路径(直接优化): DPO 完全绕过奖励模型。它不再先将人类偏好转化为奖励分数、再围绕该分数进行优化,而是直接利用偏好数据来更新 LLM 的策略。
- 它基于一种将偏好数据与最优策略直接联系起来的数学关系。简而言之,这相当于在告诉模型:提高生成
更受偏好回复的概率,降低生成不受偏好回复的概率。
本质上,DPO 直接依据人类偏好数据优化语言模型,从而简化对齐流程——省去了单独训练奖励模型并在训练中反复调用它所带来的复杂性与不稳定性,使对齐过程更高效、更稳健。
实践应用与用例
自适应智能体通过经验数据驱动的迭代更新,在动态多变的环境中展现出更强的性能。
- 个性化助手智能体: 通过对个体用户行为的长期追踪分析,持续优化交互方式与回复质量。
- 交易机器人智能体: 依据高精度实时市场数据动态调参,优化决策算法,提升收益并降低风险。
- 应用智能体: 根据观测到的用户行为动态调整 UI 与功能,提升用户参与度与系统易用性。
- 机器人与自动驾驶智能体: 融合传感器数据与历史动作分析,增强导航与响应能力,在多样化环境中安全高效运行。
- 欺诈检测智能体: 以新识别的欺诈模式持续精炼预测模型,改进异常检测、加强安全保障并减少经济损失。
- 推荐智能体: 借助用户偏好学习算法提升推荐精度,提供高度个性化且情境契合的内容推荐。
- 游戏 AI 智能体: 动态调整策略算法,提升玩家参与度与游戏挑战性。
- 知识库学习智能体: 可利用 RAG 维护问题描述与已验证解法的动态知识库(见第 14 章);通过沉淀成功策略与曾遇到的难题,在决策时按需检索,更有效地适应新情境,复用成功模式、规避已知陷阱。
案例研究:自改进编程智能体(SICA)
由 Maxime Robeyns、Laurence Aitchison 与 Martin Szummer 开发的自改进编程智能体(SICA),展示了智能体自主修改自身源码的能力,代表了基于智能体学习领域的一项重要进展。这与「一个智能体训练另一个」的传统路径不同——SICA 同时扮演修改者与被修改对象的双重角色,通过迭代精炼代码库,在多种编程挑战中持续提升表现。
SICA 的自改进依托迭代闭环(见图 1):先回顾历史版本及其基准表现,按成功率、耗时与算力成本等加权打分,选出最优版本作为下一轮改动的起点;该版本分析档案、寻找可改进之处并直接改写代码库,随后新版本再次跑分入库。循环往复,使改进直接锚定在可观测的表现上;由此,SICA 不必依赖传统训练范式也能持续演进。
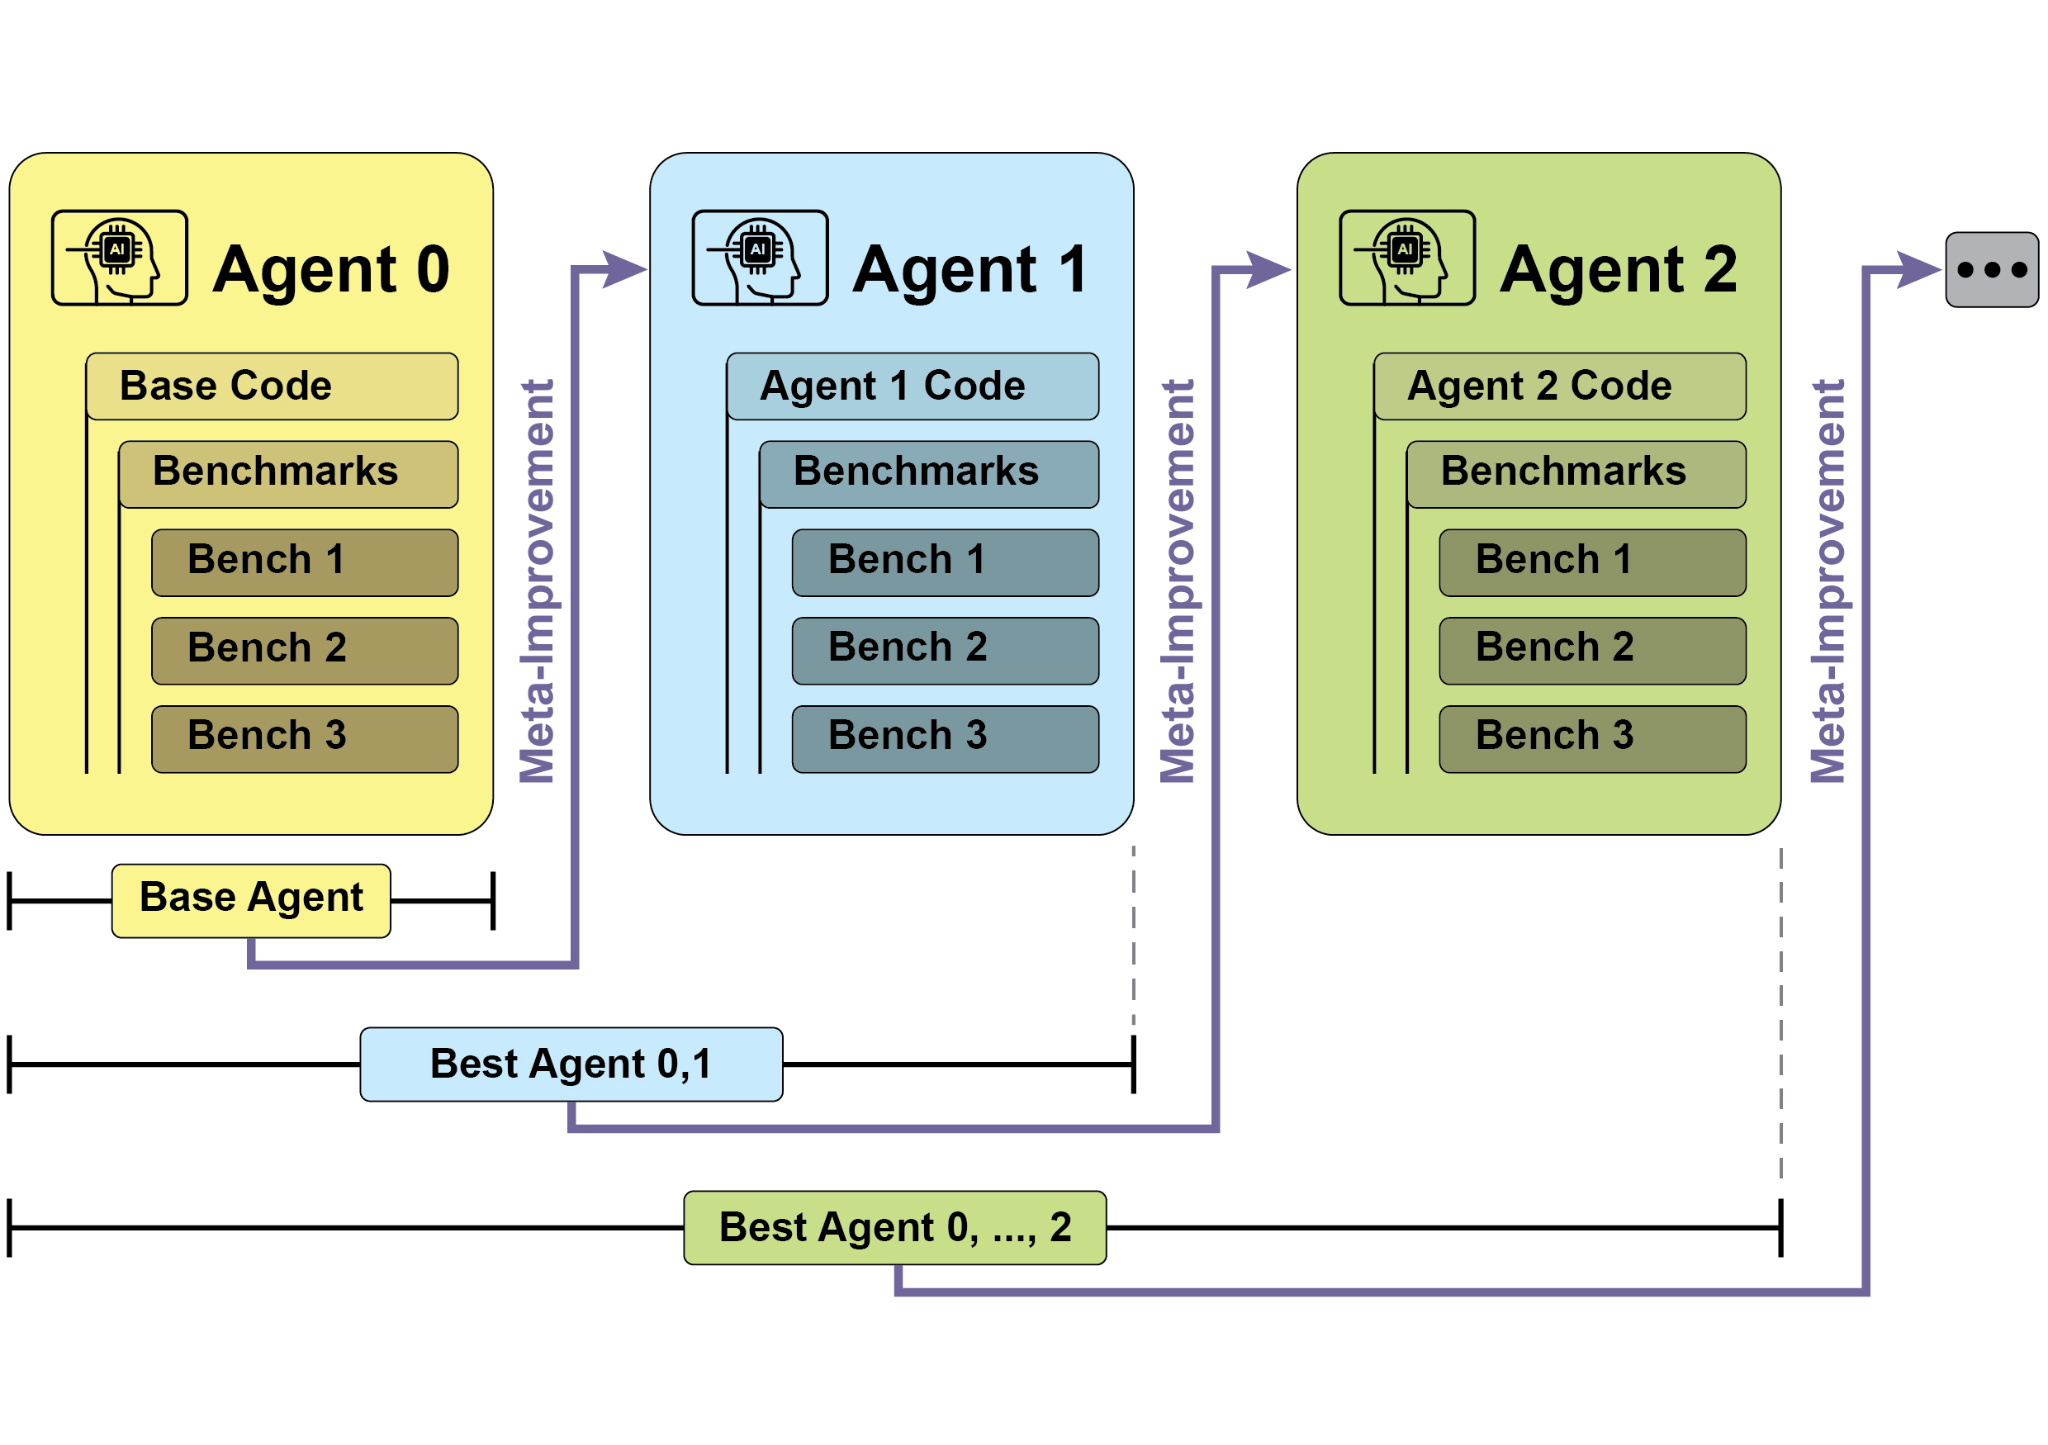
图 1:SICA 基于过往版本的自改进、学习与适应
SICA 经多轮自改进,在代码编辑与导航上进展显著:起初以整文件覆盖等基础方式修改代码;随后发展出更智能、更具上下文感知能力的「Smart Editor」;再演化为结合 diff 做定向修改与模式编辑的「Diff-Enhanced Smart Editor」,以及用于降低处理负担的「Quick Overwrite Tool」。
SICA 还实现「Minimal Diff Output Optimization」与「Context-Sensitive Diff Minimization」,借助 AST 解析提高效率;并加入「SmartEditor Input Normalizer」。导航方面,它独立创建「AST Symbol Locator」,用代码结构图(AST)在代码库中定位定义;后又发展「Hybrid Symbol Locator」,结合快速搜索与 AST 校验;再通过「Optimized AST Parsing in Hybrid Symbol Locator」聚焦相关代码段以提速(见图 2)。
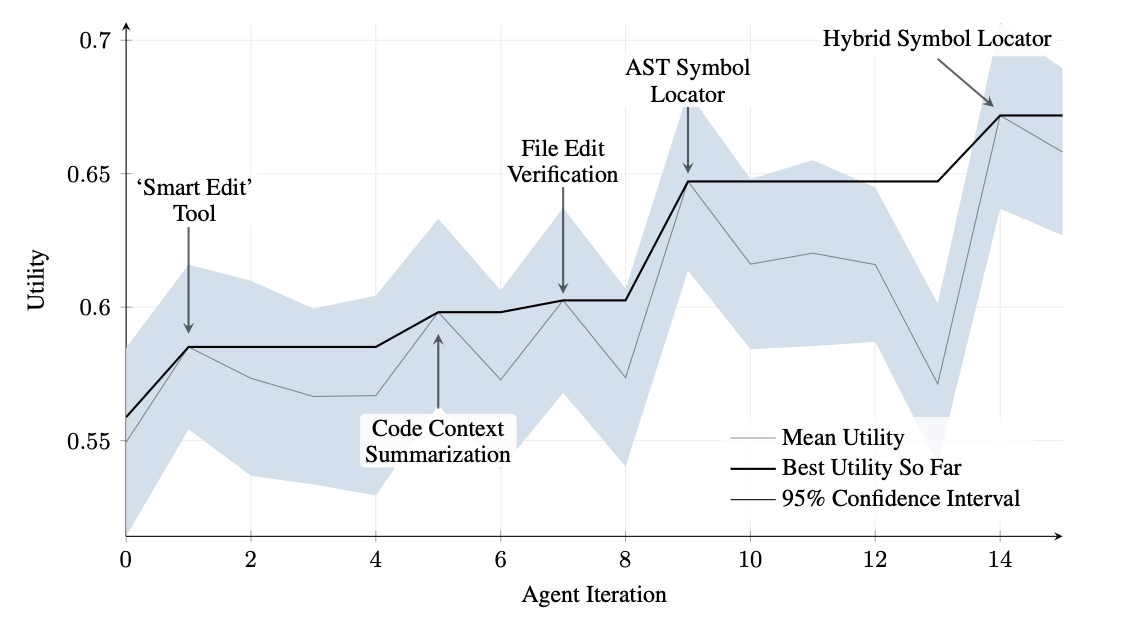
图 2:各迭代上的性能表现;关键改进标注了对应的工具或智能体修改。(Maxime Robeyns、Martin Szummer、Laurence Aitchison 提供)
SICA 的架构包含基础文件操作、命令执行与算术等工具集,也包含结果提交机制以及专用子智能体(编程、解题、推理)的调用能力;这些子智能体负责拆解复杂任务,并在长期改进循环中帮助管理 LLM 的上下文长度。
异步监督者(另一 LLM)持续监控 SICA 的运行行为,识别循环或停滞等异常;可与 SICA 通信并在必要时中止执行;监督者收到含调用图与消息及工具动作日志的详细报告,以发现规律性问题与低效之处。
SICA 的 LLM 以结构化方式组织上下文窗口(短期记忆)中的信息,这对其运行至关重要:系统提示定义智能体目标、工具与子智能体文档及系统指令;核心提示包含问题陈述或指令、当前已打开的文件内容与目录结构图;助手消息记录逐步推理过程、工具与子智能体的调用及结果,以及与监督者的通信。这种结构化组织有助于提升信息流效率、改善 LLM 运行并降低处理时间与成本。起初文件变更以 diff 记录,仅显示修改部分并定期合并。
SICA:代码解析: 深入其实现可见若干关键设计:模块化架构与多个专用子智能体(编程、解题、推理等);主智能体像调用工具一样调用它们,以分解复杂任务并高效管理上下文,在漫长的元改进迭代中尤为重要。
项目持续活跃开发中,旨在为希望在工具使用及其他智能体任务上对 LLM 进行后训练的研究者提供稳健框架;完整代码已开源于 GitHub 仓库,欢迎探索与贡献。
安全方面,项目强调 Docker 容器化:智能体在专用容器中运行,与宿主机有效隔离,从而规避智能体在执行 shell 命令过程中意外操作文件系统等风险。
为保障透明度与可控性,系统通过交互式网页提供完善的可观测能力:可视化展示事件总线上的事件与智能体调用图,便于检视单次事件、阅读监督者消息、折叠子智能体轨迹以理清脉络。
在模型侧,框架可对接多家 LLM 提供商,便于按任务需求试验不同模型以找到最佳配置。另一关键组件是异步监督者:与主智能体并行运行,周期性检视其是否陷入循环、停滞或异常路径,必要时发送通知甚至终止运行;它接收系统状态的详细文本表示——含调用图以及由 LLM 消息、工具调用与响应构成的事件流——据此识别低效模式与重复劳动。
初期 SICA 实现中一大挑战在于:如何在每次元改进迭代中引导基于 LLM 的智能体独立提出新颖、创新、可行且吸引人的修改方案。在促进开放式学习与 LLM 智能体真实创造力方面,这一问题仍是当前研究的重要议题。
AlphaEvolve 与 OpenEvolve
AlphaEvolve 是 Google 开发的 AI 智能体,用于发现与优化算法;结合 LLM(Gemini Flash 与 Pro)、自动评估系统与进化算法框架,旨在推进理论数学与实用计算应用。
AlphaEvolve 使用 Gemini 模型组合:Flash 生成大量初始算法提案,Pro 做更深入分析与精炼;提案再按预设标准自动评估打分,反馈用于迭代改进,得到优化且新颖的算法。
在实用计算中,AlphaEvolve 已部署于 Google 基础设施:数据中心调度优化使全球算力使用量约降 0.7%;通过为下一代 TPU 的 Verilog 代码提供优化建议,参与硬件设计工作;还在 AI 性能方面取得加速,包括在 Gemini 架构某核心内核上实现约 23% 的提速,以及对 FlashAttention 底层 GPU 指令最高约 32.5% 的优化。
在基础研究方面,AlphaEvolve 助力发现矩阵乘法新算法,其中包括针对 4×4 复矩阵仅需 48 次标量乘法、优于此前已知最优结果的方法;在更广泛的数学研究中,针对 50 余个开放问题,约 75% 的情况下复现了已知最优解,约 20% 的情况下改进了既有解,接吻数问题即为一例。
OpenEvolve 是借助 LLM(见图 3)迭代优化代码的进化式编程智能体;它编排由 LLM 驱动的代码生成、评估与选择流水线,持续提升各类任务的程序质量。其要点之一是能进化整个代码文件,而非仅限单个函数;设计上注重通用性,支持多种编程语言,兼容任意符合 OpenAI API 规范的 LLM;此外还内置多目标优化、灵活的提示工程与分布式评估能力,以高效应对复杂编程挑战。
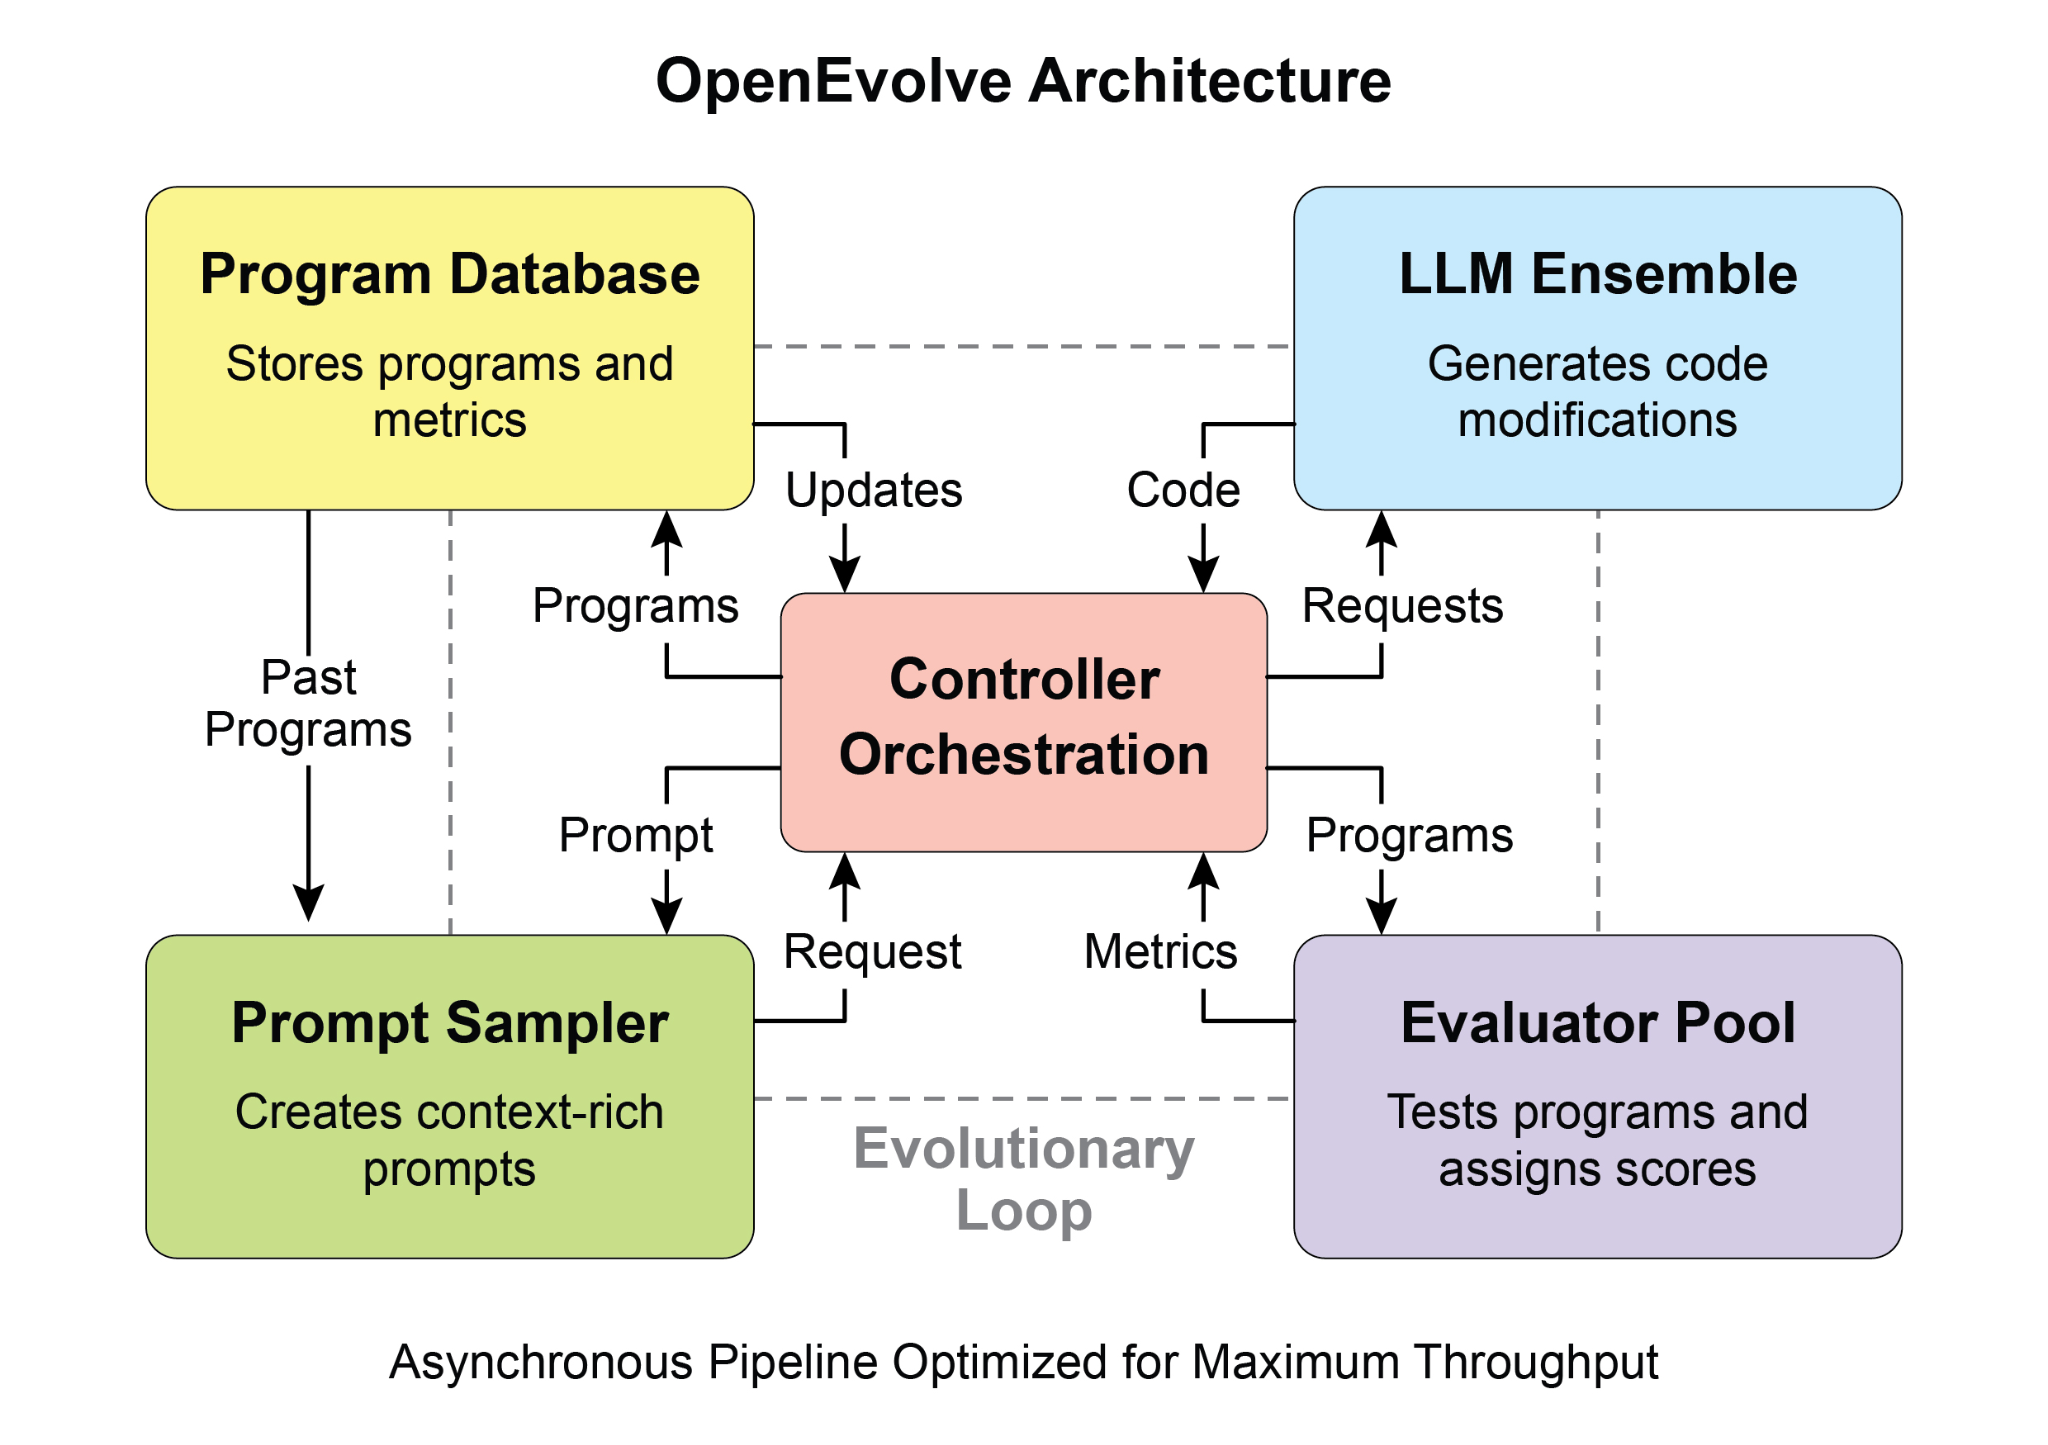
图 3:OpenEvolve 内部架构由控制器统一管理;控制器协调程序采样器、程序数据库、评估器池与 LLM 集成模型等核心组件,主要职责是驱动各组件的学习与适应过程,从而持续提升代码质量。
以下代码片段使用 OpenEvolve 库对程序做进化优化:用初始程序、评估文件与配置文件路径初始化系统;evolve.run(iterations=1000) 启动进化过程,运行 1000 次迭代以寻找改进版本;最后打印进化过程中最优程序的指标,保留四位小数。
from openevolve import OpenEvolve

# Initialize the system
evolve = OpenEvolve(
    initial_program_path="path/to/initial_program.py",
    evaluation_file="path/to/evaluator.py",
    config_path="path/to/config.yaml",
)

# Run the evolution
best_program = await evolve.run(iterations=1000)

print("Best program metrics:")
for name, value in best_program.metrics.items():
print(f" {name}: {value:.4f}")一览
问题: 智能体常运行于动态、不可预测的环境中,单靠预编程逻辑往往不足;一旦遇到设计阶段未覆盖的新情境,系统表现就可能明显下滑。若不能从经验中学习,便无法持续优化策略或逐步实现个性化交互,这种僵化会直接限制其有效性,并阻碍其在复杂真实场景中实现真正的自主运行。
解决方案: 标准做法是将学习与适应机制融入系统,将静态智能体转变为动态演进的系统,使其能够基于新数据与交互自主精炼知识与行为。智能体系统可采用多种方法——从强化学习到代码自修改等进阶技术均可纳入(如 SICA);Google AlphaEvolve 等系统更进一步,结合 LLM 与进化算法发现全新且更高效的复杂问题解法。持续学习使智能体能够掌握新任务、提升表现、适应不断变化的条件,而无需人工频繁重新编程。
经验法则: 构建须在动态、不确定或演进环境中运行的智能体时使用本模式;对需要个性化、持续性能改进及自主应对新情境的应用尤为关键。
图示摘要:
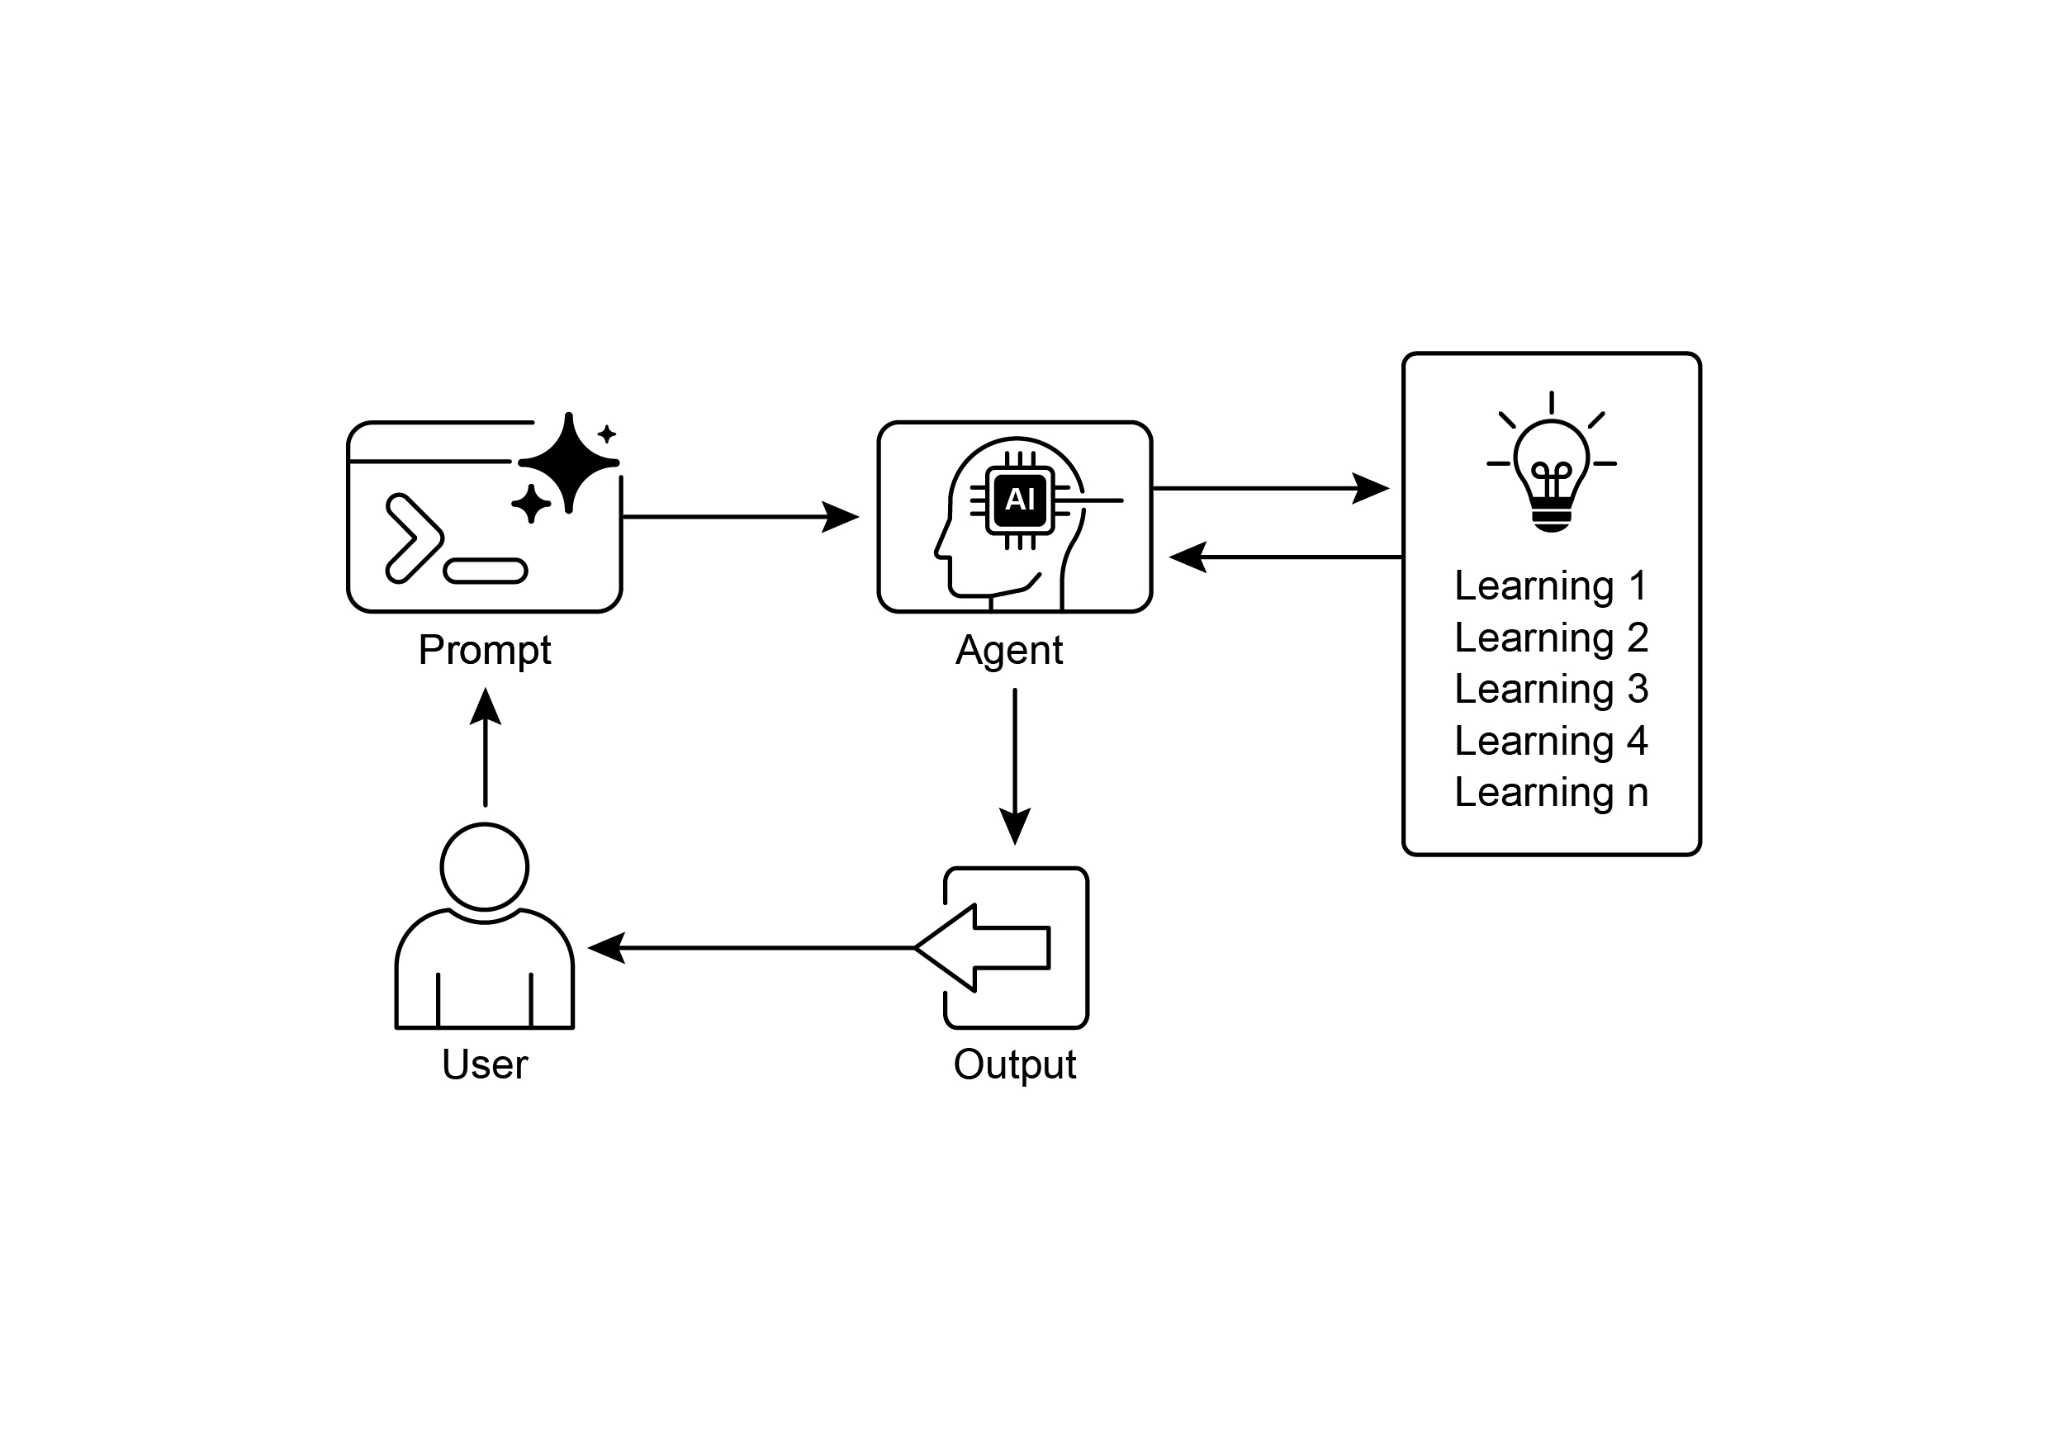
图 4:学习与适应模式
要点
- 学习与适应指智能体借助经验积累持续提升能力、有效应对新情境。
- 「适应」是学习带来的行为或知识上的可见变化。
- SICA 通过基于历史表现修改代码实现自改进,由此催生了 Smart Editor、AST Symbol Locator 等工具。
- 专用「子智能体」与「监督者」有助于自改进系统管理复杂任务、保持正轨。
- LLM「上下文窗口」的结构化组织方式(系统提示、核心提示、助手消息)对智能体运行效率极为重要。
- 本模式对需在持续变化、不确定或强调个性化交互的环境中运行的智能体至关重要。
- 构建具备学习能力的智能体,通常需要接入机器学习工具并妥善管理数据流。
- 配备基础编程工具的智能体系统可自主编辑自身代码,从而在基准任务上持续改进表现。
- AlphaEvolve 是 Google 结合 LLM 与进化框架自主发现与优化算法的 AI 智能体,显著推动了基础研究与实用计算应用的发展。
结语
本章考察学习与适应在人工智能中的关键作用:智能体通过持续获取数据与经验提升表现;SICA 通过修改代码自主改进能力,是典型例证。
我们已回顾 AI 智能体的核心构件:架构、应用、规划、多智能体协作、记忆管理与学习适应。学习原则对多智能体系统中的协同改进尤为关键;为此,微调数据须准确反映完整的交互轨迹,捕获各参与智能体的输入与输出。
这些要素共同催生了重大进展,Google 的 AlphaEvolve 即为一例:该系统借助 LLM、自动评估与进化方法独立发现并精炼算法,推动了科学研究与计算技术的持续进步。此类模式可相互组合,构建更复杂的 AI 系统;AlphaEvolve 等进展有力地表明,由 AI 智能体自主进行算法发现与优化已成为现实。
参考资料
- Sutton, R. S., & Barto, A. G. (2018). Reinforcement Learning: An Introduction. MIT Press.
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press.
- Mitchell, T. M. (1997). Machine Learning. McGraw-Hill.
- Proximal Policy Optimization Algorithms,作者:John Schulman、Filip Wolski、Prafulla Dhariwal、Alec Radford 和 Oleg Klimov。可在 arXiv 查阅:https://arxiv.org/abs/1707.06347
- Robeyns, M., Aitchison, L., & Szummer, M. (2025). A Self-Improving Coding Agent. arXiv:2504.15228v2. https://arxiv.org/pdf/2504.15228;https://github.com/MaximeRobeyns/self_improving_coding_agent
- AlphaEvolve 博客:https://deepmind.google/discover/blog/alphaevolve-a-gemini-powered-coding-agent-for-designing-advanced-algorithms/
- OpenEvolve:https://github.com/codelion/openevolve