第 6 章:规划
智能行为往往不只是对当前输入做出反应,还需要前瞻性:把复杂任务拆成更小、可管理的步骤,并规划如何达成目标。这正是规划(Planning)模式的作用所在。其核心在于,智能体或多智能体系统能够制定一系列行动,从初始状态走向目标状态。
规划模式概览
在 AI 语境中,可以把规划智能体看作一位能承接复杂目标的专家。当你让它「组织一次团队外出活动」时,你给出的是目标及其约束,而不是具体做法。智能体的核心任务,是自主规划通往目标的路径:先厘清初始状态(如预算、人数、意向日期)与目标状态(活动成功预订),再找出连接两者的最优行动序列。计划不是预先写死的,而是根据请求动态生成的。
这一过程的关键特征是适应性:初始计划只是起点,不是僵化剧本。智能体真正的能力,在于吸纳新信息并绕开障碍继续推进。例如,若首选场地不可用或所选餐饮已订满,一个有能力的智能体不会直接失败,而会记录新约束、重新评估选项,并给出新的计划,例如更换场地或调整日期。
但也必须看到灵活性与可预测性之间的权衡。可随情境调整的规划是专门手段,并非万能解。
- 当问题的解法已经
清楚且可重复时,把智能体约束在预定的固定工作流中往往更有效:这样能减少不确定性和失控风险,从而得到更可靠、更一致的结果。 - 因此,究竟该用规划智能体还是简单任务执行智能体,归根结底取决于一个问题:「怎么做」
仍需探索,还是已经明确?
实际应用与用例
规划模式(Planning) 是自主系统中的核心过程之一,使智能体能够筹划一系列行动来达成既定目标,在动态或复杂环境中尤其重要。它把高层目标转化为由离散、可执行步骤组成的结构化计划。
在流程自动化等领域,规划常用于编排复杂工作流。例如,新员工入职可以拆成一组有依赖关系的子任务:创建系统账号、分配培训模块、与各部门协调等。智能体会先生成计划,再按逻辑顺序执行这些步骤,并通过调用工具或与各系统交互来处理依赖关系。
在机器人与自主导航领域,规划是系统在状态空间中寻路和决策的基础。无论是物理机器人还是虚拟实体,都必须生成一条路径或一系列行动,使系统从初始状态过渡到目标状态。这要求它在时间、能耗等指标上进行优化,同时满足环境约束,例如避开障碍物或遵守交通规则。
该模式对结构化信息整合同样重要。比如在撰写研究报告这类复杂任务中,智能体可以先制定计划,再分阶段完成信息收集、数据摘要、内容组织和迭代润色。同样,在需要多步解决问题的客服场景中,智能体也可以建立并遵循系统化的诊断、处理与升级路径。
本质上,规划模式(Planning) 让智能体从单纯的反应式行为走向目标导向行为,为那些需要连贯且相互依赖的操作序列的问题提供必要的逻辑框架。
动手代码示例(Crew AI)
下面演示如何用 Crew AI 实现规划者(Planner)模式:智能体先为复杂查询拟定多步计划,再按顺序执行。
import os
from dotenv import load_dotenv
from crewai import Agent, Task, Crew, Process
from langchain_openai import ChatOpenAI

# Load environment variables from .env file for security
load_dotenv()

# 1. Explicitly define the language model for clarity
llm = ChatOpenAI(model="gpt-4-turbo")

# 2. Define a clear and focused agent
planner_writer_agent = Agent(
    role='Article Planner and Writer',
    goal='Plan and then write a concise, engaging summary on a specified topic.',
    backstory=(
        'You are an expert technical writer and content strategist. '
        'Your strength lies in creating a clear, actionable plan before writing, '
        'ensuring the final summary is both informative and easy to digest.'
    ),
    verbose=True,
    allow_delegation=False,
    llm=llm,  # Assign the specific LLM to the agent
)

# 3. Define a task with a more structured and specific expected output
topic = "The importance of Reinforcement Learning in AI"

high_level_task = Task(
    description=(
        f"1. Create a bullet-point plan for a summary on the topic: '{topic}'.\n"
        f"2. Write the summary based on your plan, keeping it around 200 words."
    ),
    expected_output=(
        "A final report containing two distinct sections:\n\n"
        "### Plan\n"
        "- A bulleted list outlining the main points of the summary.\n\n"
        "### Summary\n"
        "- A concise and well-structured summary of the topic."
    ),
    agent=planner_writer_agent,
)

# Create the crew with a clear process
crew = Crew(
    agents=[planner_writer_agent],
    tasks=[high_level_task],
    process=Process.sequential,
)

# Execute the task
print("## Running the planning and writing task ##")
result = crew.kickoff()

print("\n\n---\n## Task Result ##\n---")
print(result)该代码用 CrewAI 构建了一个既能规划又能撰写摘要的智能体:先导入 crewai、langchain_openai 等依赖,并从 .env 加载环境变量;再显式实例化 ChatOpenAI 供智能体使用。planner_writer_agent 的目标是先规划、后写作,其背景设定强调规划与技术写作能力。任务要求先列出摘要提纲,再围绕 「The importance of Reinforcement Learning in AI」写一段约 200 词的总结,并明确规定输出格式。最后将智能体和任务编入 Crew,采用顺序流程,通过 crew.kickoff() 执行并打印结果。
Google DeepResearch
Google Gemini DeepResearch(见图 1)是一套面向自主信息检索与综合的智能体系统。它通过多步流水线动态、迭代地调用 Google 搜索,系统性地探索复杂主题。系统能够处理大量网页来源,评估已获取信息的相关性与知识缺口,并持续搜索补全;最终把核实后的内容整合成带引用的结构化多页摘要。
更具体地说,它不是一次性的问答系统,而是一个受控的长流程:先把用户提示拆成多点研究计划(见图 1),交给用户审阅和修改,以便在执行前共同确定研究方向。计划获批后,系统进入迭代式的搜索—分析循环。它不只是按预设顺序检索,还会根据已获取的信息动态调整查询,主动发现缺口、交叉验证数据,并处理彼此矛盾之处。
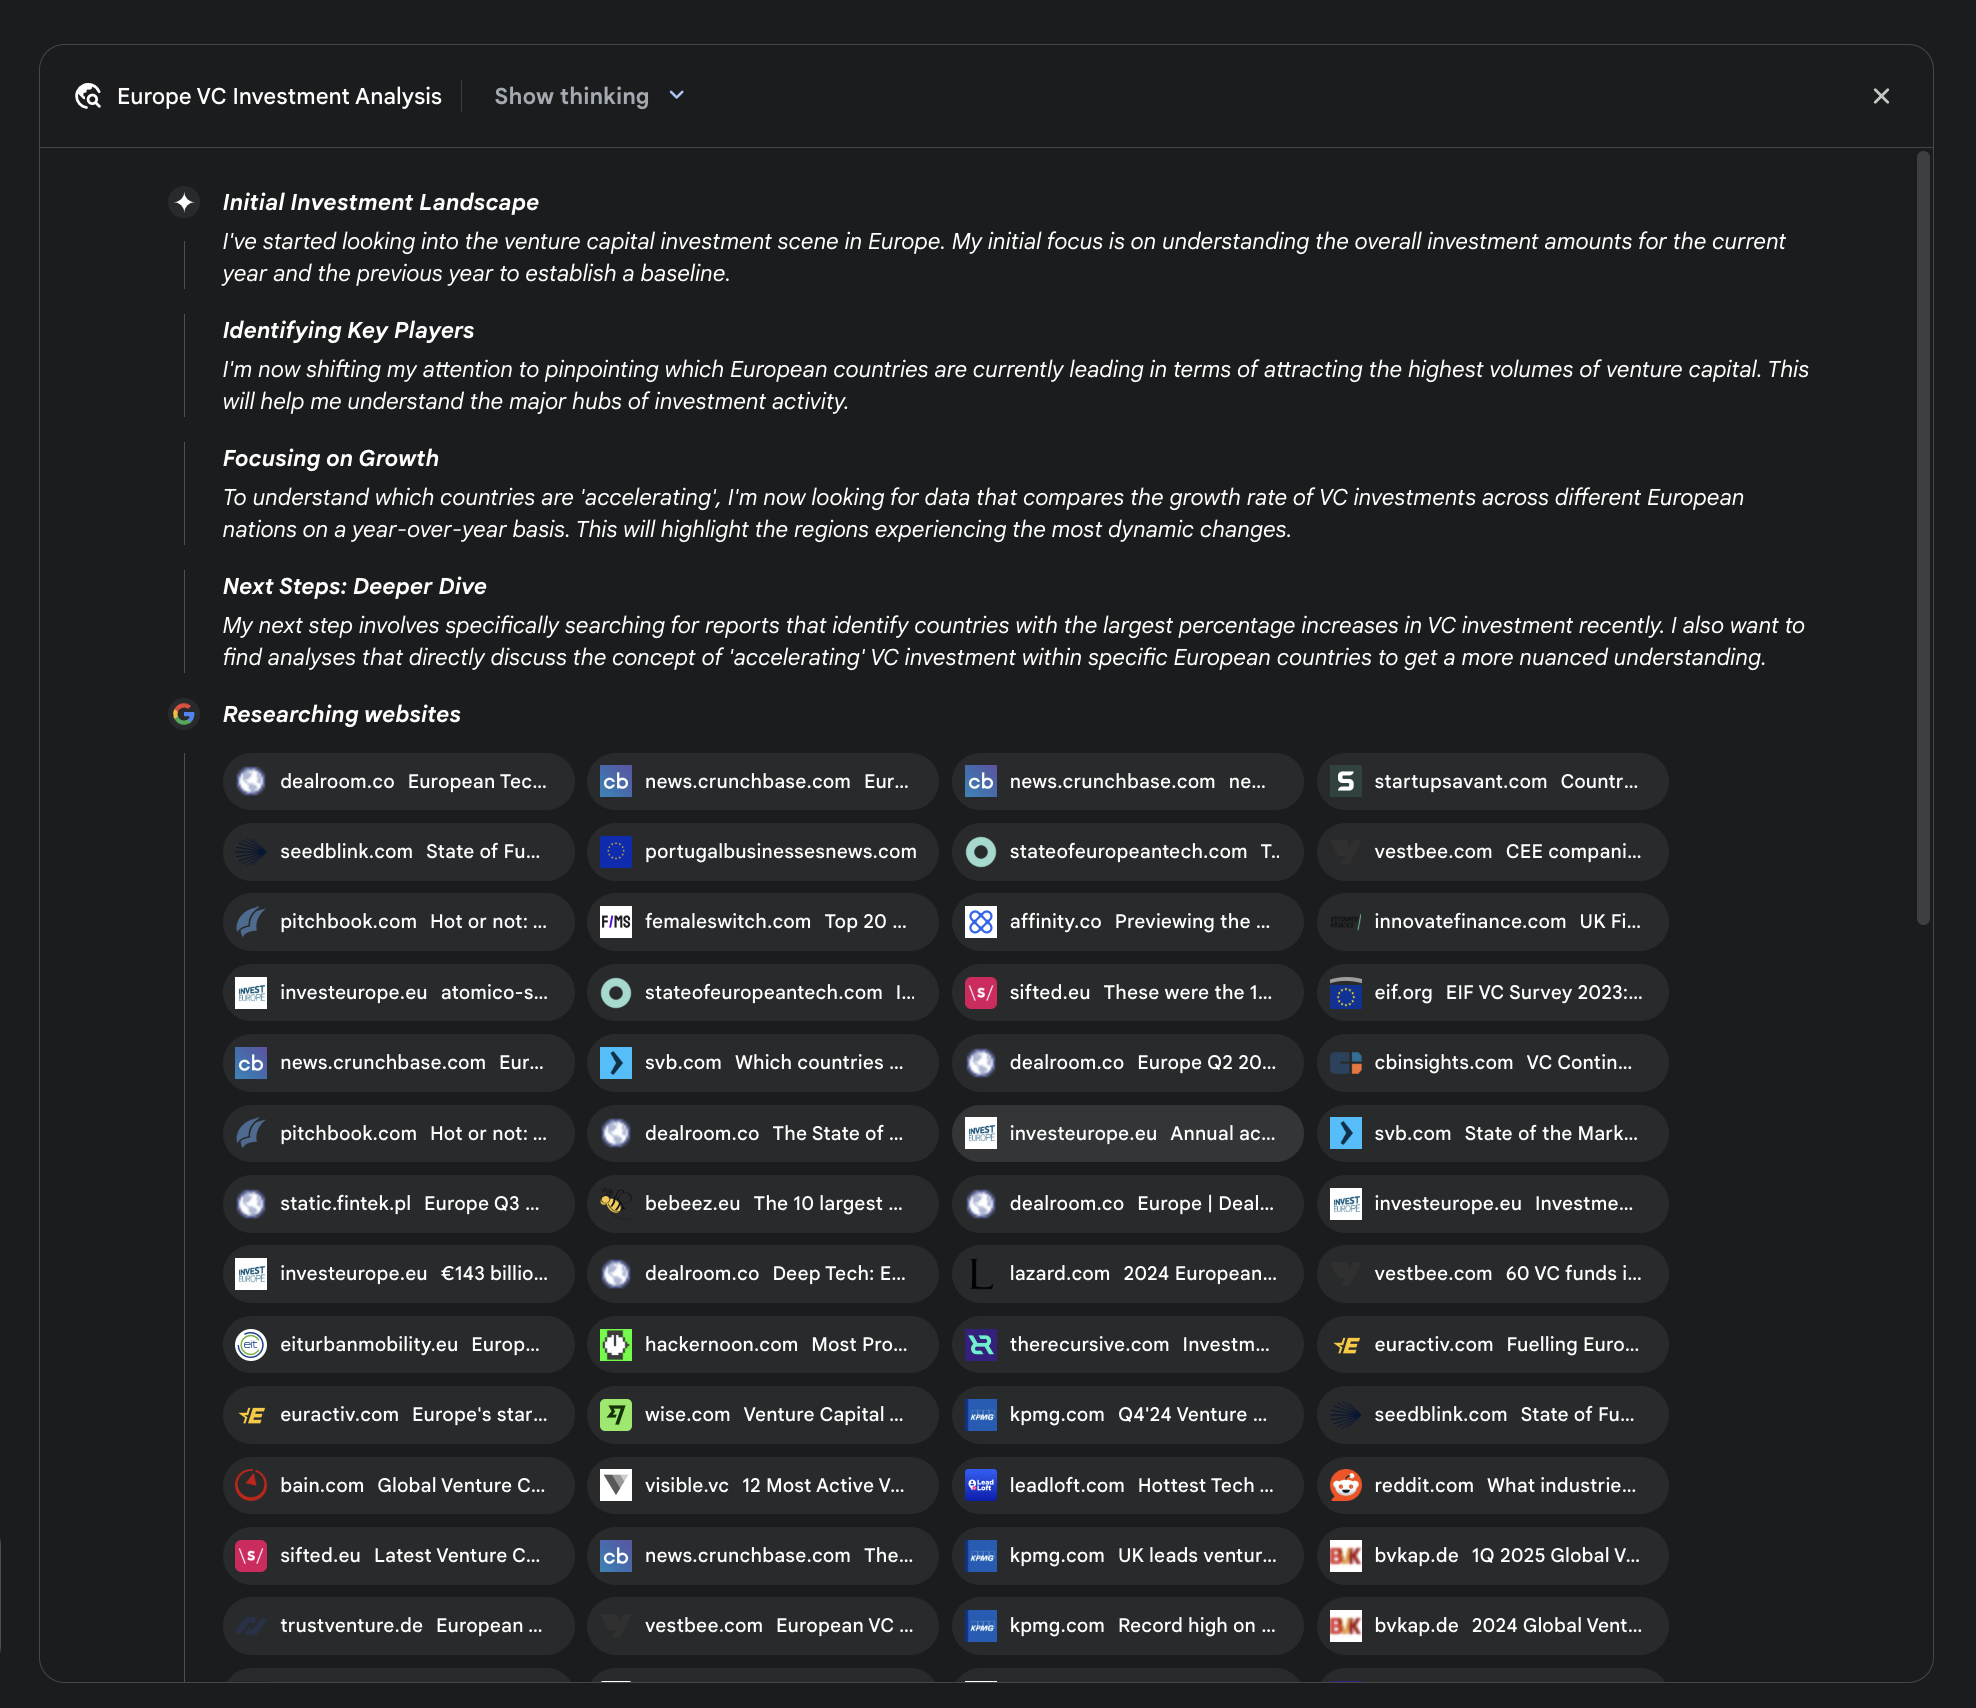
图 1:Google Deep Research 智能体生成将 Google 搜索作为工具使用的执行计划。
其关键架构能力之一,是以异步方式管理整个流程。由于调查可能涉及数百个来源,这种设计既能增强对单点故障的容忍度,也允许用户中途离开并在完成时收到通知。系统还可以接入用户提供的文档,把私有材料与网页检索结合起来。最终产出并不是简单罗列信息,而是一份结构化的多页报告;在综合阶段,模型会对收集到的信息进行批判性评估,提炼主题,并组织成逻辑清晰的章节。报告通常还带有音频概览、图表以及指向原始来源的链接,便于核查和继续阅读。除综合结果外,系统还会显式返回完整的检索来源列表(见图 2),以提高透明度并方便追溯。整个过程把一个简单问题转化为系统化的知识产出。
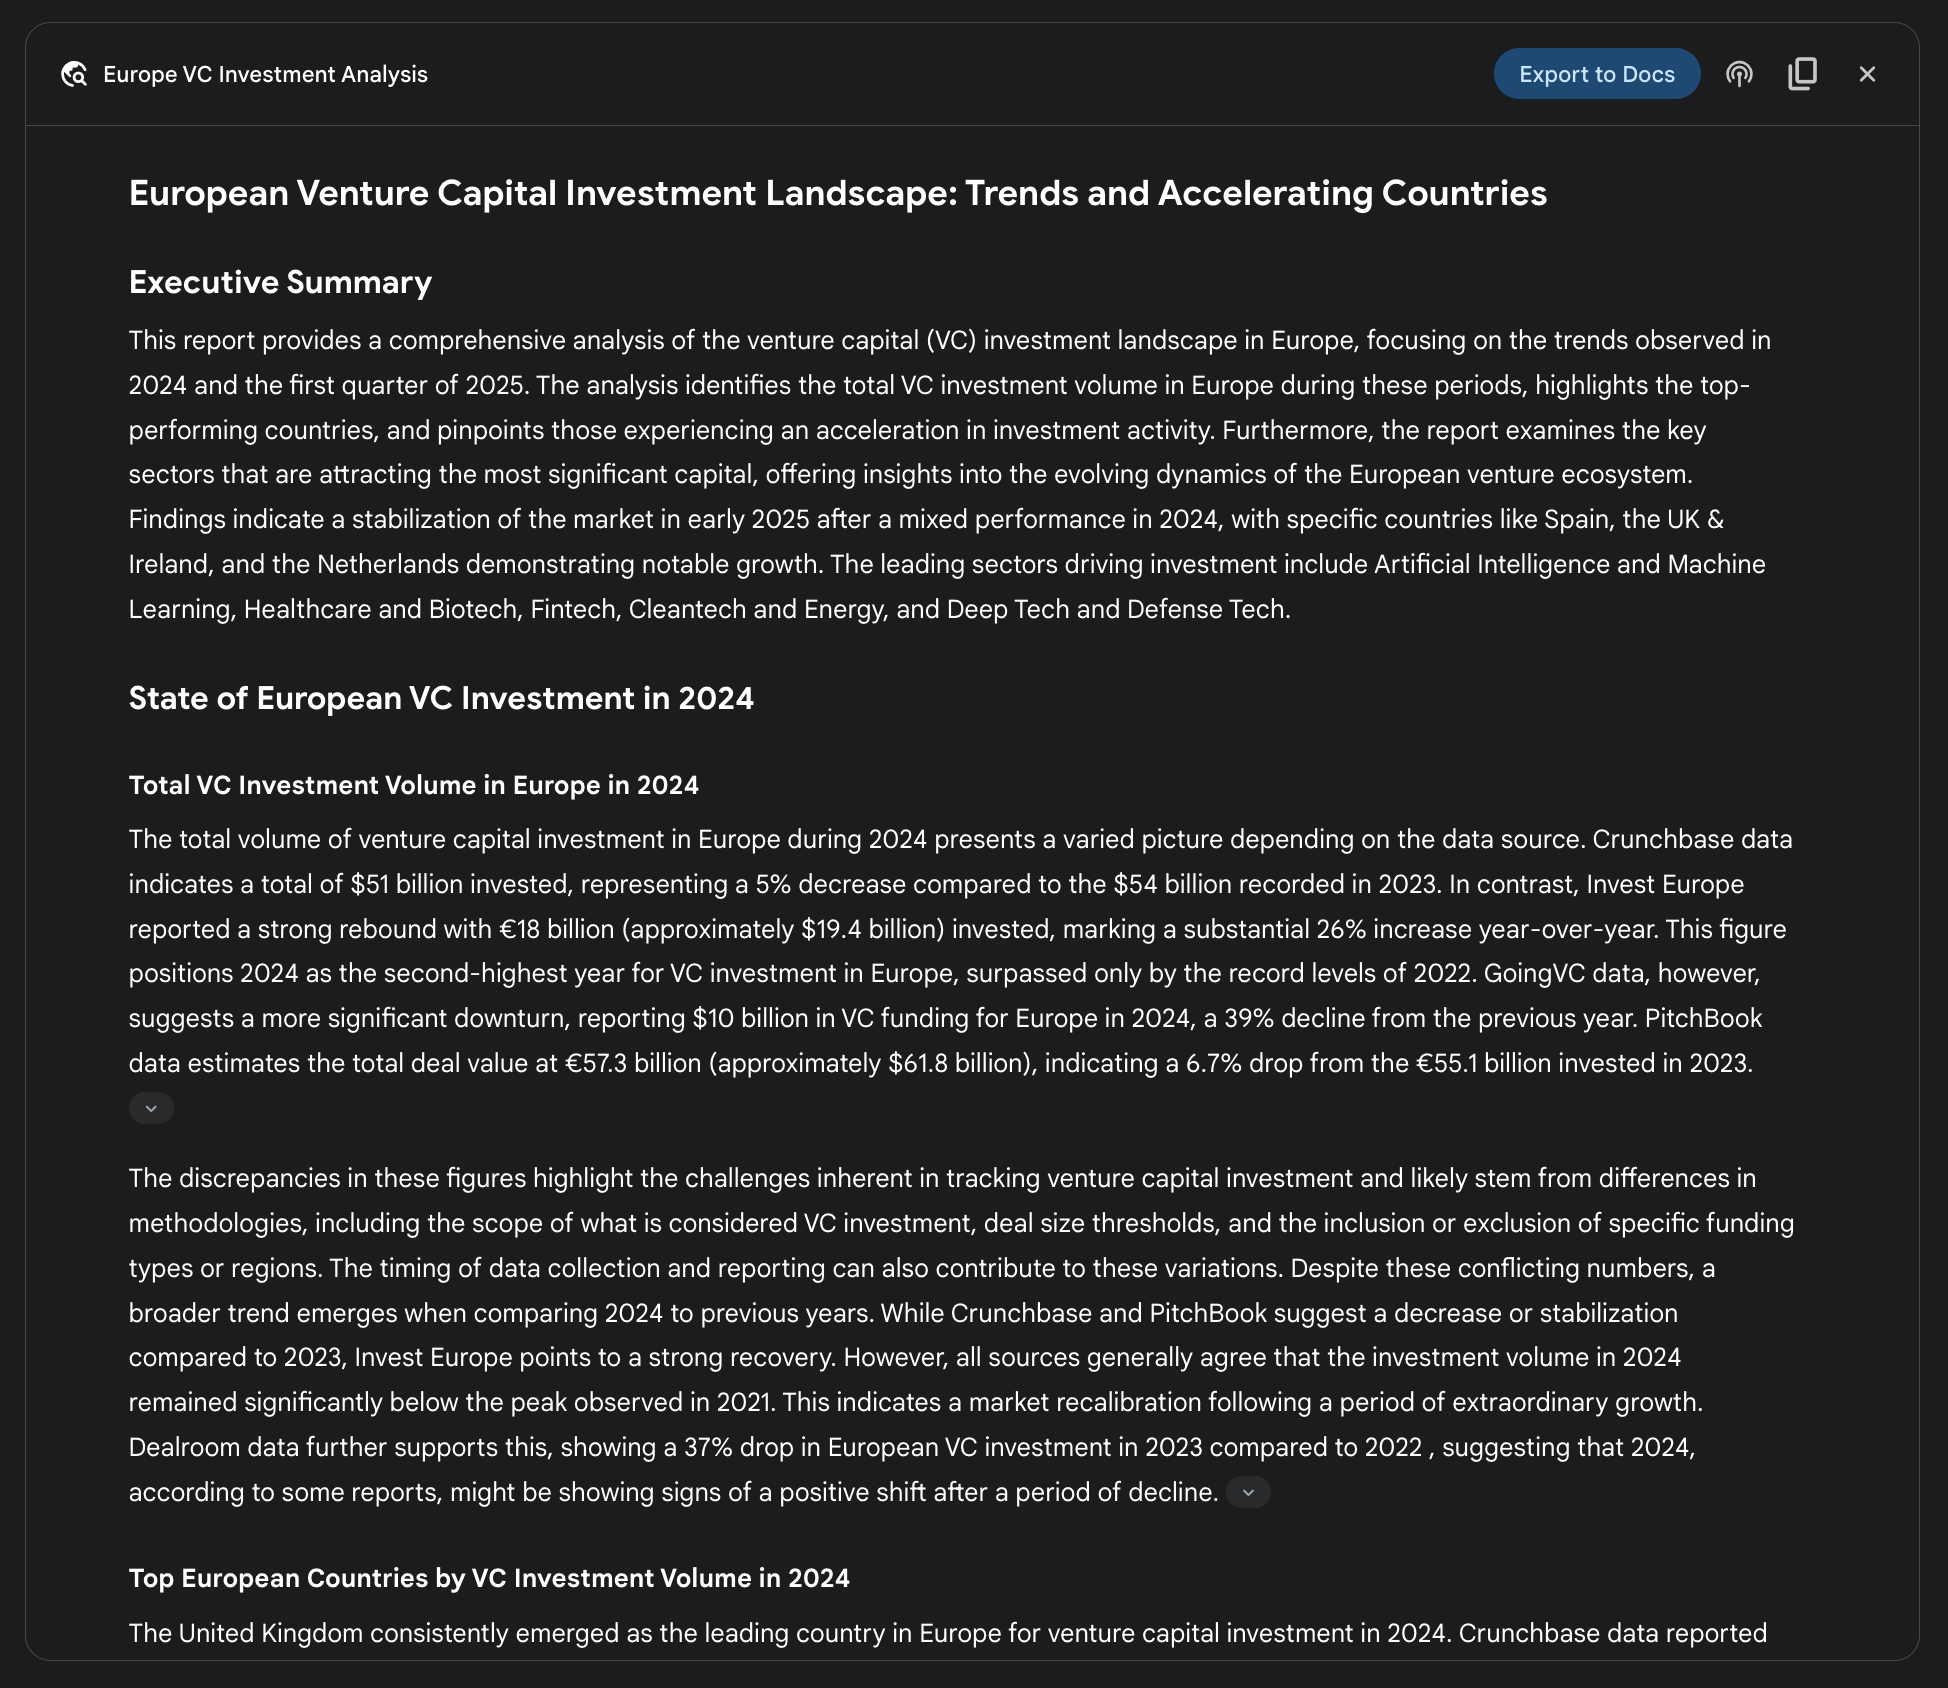
图 2:Deep Research 计划执行示例——以 Google 搜索为工具检索各类网页来源。
通过大幅降低手工采集与综合所需的时间和成本,Gemini DeepResearch 为信息发现提供了更结构化、覆盖更全面的方式;在跨领域、多维度的复杂研究任务中,其价值尤为突出。
例如在竞争分析场景中,可以引导智能体系统性地收集并整理市场趋势、竞品规格、多源舆情与营销策略等数据,替代手工跟踪多个竞争对手的繁重工作,使分析人员把精力更多放在高层次的战略判断上,而不是数据采集本身(见图 3)。
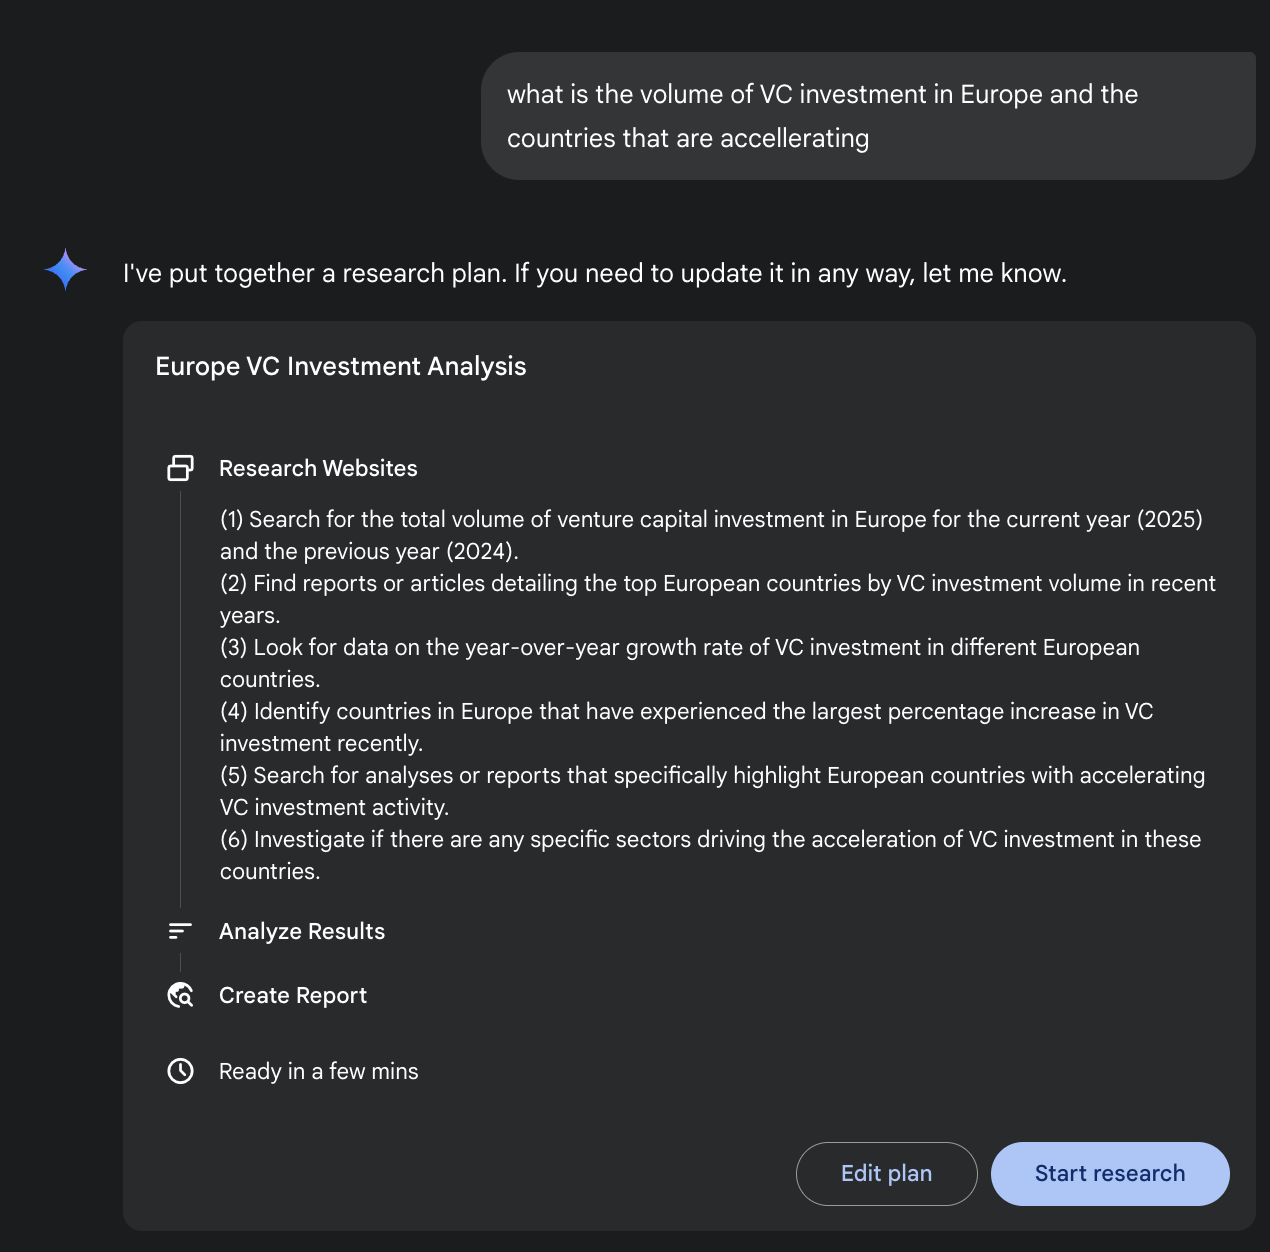
图 3:Google Deep Research 智能体生成的最终输出——基于通过 Google 搜索获取的来源进行分析。
同样,在学术探索中,该系统也能有力支撑大规模文献综述:识别并总结奠基性文献,追踪概念在大量出版物中的演进,并勾勒特定领域的新兴研究前沿,从而缩短学术研究最初、也最耗时的阶段。
其效率来自对「搜索—筛选—再搜索」这一迭代循环的自动化,而这恰恰是手工研究的主要瓶颈。其全面性则来自系统在相近时间内处理远超人类研究者通常能覆盖之来源规模和多样性的能力。更广的分析范围有助于降低选择性偏差,并提高发现隐蔽却关键之信息的概率,从而形成更稳健、证据更充分的理解。
OpenAI Deep Research API
OpenAI Deep Research API 面向复杂研究任务的自动化,依托能够独立推理、规划并从真实世界来源综合信息的高级智能体模型。与简单问答模型不同,它接收高层查询后,会自主拆分子问题,借助内置工具执行网页检索,并交付结构化、引用充分的最终报告。该 API 以编程方式开放了这整套流程;截至本文撰写时,可选用 o3-deep-research-2025-06-26 侧重高质量综合,或 o4-mini-deep-research-2025-06-26 兼顾低延迟场景。
Deep Research API 的价值在于把原本需要数小时的手工研究,自动化为可编程流程,并产出专业级、数据驱动的报告,适用于商业战略、投资决策或政策研判等场景。其主要优势包括:
- 结构化且带引用的输出: 生成条理清晰的报告,并附行内引用和来源元数据,使论断可核实、有据可查。
- 透明性: 与 ChatGPT 中较为抽象的过程不同,API 暴露完整的中间步骤,包括智能体推理、实际执行的网页搜索查询以及运行过的代码,便于调试、复盘并理解最终答案的形成过程。
- 可扩展性: 支持模型上下文协议(MCP),开发者可以将智能体接入私有知识库与内部数据源,把公开网页研究与专有信息结合起来。
调用时,需要向 client.responses.create 端点发送请求,指定模型、输入提示以及智能体可调用的工具。输入通常包括用于界定角色和输出格式的 system_message,以及 user_query;必须包含 web_search_preview 工具,也可以按需加入 code_interpreter 或自定义 MCP 工具(见第 10 章)来访问内部数据。
from openai import OpenAI

# Initialize the client with your API key
client = OpenAI(api_key="YOUR_OPENAI_API_KEY")

# Define the agent's role and the user's research question
system_message = """
You are a professional researcher preparing a structured, data-driven report.
Focus on data-rich insights, use reliable sources, and include inline citations.
"""

user_query = "Research the economic impact of semaglutide on global healthcare systems."

# Create the Deep Research API call
response = client.responses.create(
    model="o3-deep-research-2025-06-26",
    input=[
        {
            "role": "developer",
            "content": [{"type": "input_text", "text": system_message}],
        },
        {
            "role": "user",
            "content": [{"type": "input_text", "text": user_query}],
        },
    ],
    reasoning={"summary": "auto"},
    tools=[{"type": "web_search_preview"}],
)

# Access and print the final report from the response
final_report = response.output[-1].content[0].text
print(final_report)

# --- ACCESS INLINE CITATIONS AND METADATA ---
print("--- CITATIONS ---")
annotations = response.output[-1].content[0].annotations

if not annotations:
    print("No annotations found in the report.")
else:
    for i, citation in enumerate(annotations):
        # The text span the citation refers to
        cited_text = final_report[citation.start_index : citation.end_index]
        print(f"Citation {i + 1}:")
        print(f"  Cited Text: {cited_text}")
        print(f"  Title: {citation.title}")
        print(f"  URL: {citation.url}")
        print(f"  Location: chars {citation.start_index}–{citation.end_index}")

print("\n" + "=" * 50 + "\n")

# --- INSPECT INTERMEDIATE STEPS ---
print("--- INTERMEDIATE STEPS ---")

# 1. Reasoning Steps: Internal plans and summaries generated by the model.
try:
    reasoning_step = next(item for item in response.output if item.type == "reasoning")
    print("\n[Found a Reasoning Step]")
    for summary_part in reasoning_step.summary:
        print(f"  - {summary_part.text}")
except StopIteration:
    print("\nNo reasoning steps found.")

# 2. Web Search Calls: The exact search queries the agent executed.
try:
    search_step = next(item for item in response.output if item.type == "web_search_call")
    print("\n[Found a Web Search Call]")
    print(f"  Query Executed: '{search_step.action['query']}'")
    print(f"  Status: {search_step.status}")
except StopIteration:
    print("\nNo web search steps found.")

# 3. Code Execution: Any code run by the agent using the code interpreter.
try:
    code_step = next(item for item in response.output if item.type == "code_interpreter_call")
    print("\n[Found a Code Execution Step]")
    print("  Code Input:")
    print(f"  ```python\n{code_step.input}\n  ```")
    print("  Code Output:")
    print(f"  {code_step.output}")
except StopIteration:
print("\nNo code execution steps found.")该示例通过 OpenAI API 执行「Deep Research」任务:先用 API 密钥初始化客户端完成认证;再将智能体设定为专业研究者,并给出关于司美格鲁肽对全球医疗体系经济影响的研究问题;随后向 o3-deep-research-2025-06-26 发起请求,传入系统消息与用户查询,启用推理摘要和网页搜索能力;最后提取并打印最终报告。
随后,代码会从报告标注中解析并展示行内引用与元数据(如被引片段、标题、URL 以及在报告中的字符位置);最后再遍历并打印中间步骤,包括推理片段、网页搜索调用(含实际查询),以及使用代码解释器时的代码执行步骤。
速览
是什么: 复杂问题通常无法靠单一动作解决,而需要前瞻性与整体规划。若缺乏结构化方法,智能体系统就难以处理包含多步依赖的复杂请求,也难以把高层目标拆解成可管理的小任务序列。结果就是,面对复杂目标时,系统更容易给出不完整甚至错误的结果。
为什么: 规划模式提供了一种标准做法:先为目标拟定连贯计划,把高层目标拆成更小、可执行的步骤或子目标,再据此管理复杂工作流、编排多种工具,并按逻辑顺序处理依赖。LLM 尤其适合承担这类工作,因为它可以基于海量训练数据生成合理有效的计划。借助这种结构化路径,原本只会被动响应的智能体,就能转变为主动推进复杂目标、并在必要时调整计划的执行者。
经验法则: 当用户请求复杂到无法由单一动作或单一工具完成时,就适合使用规划模式。它尤其适用于多步流程自动化,例如撰写详细研究报告、新员工入职或竞争分析。凡是必须经过一串相互依赖的操作,才能得到最终综合结果的任务,都值得考虑这种模式。
图示摘要:
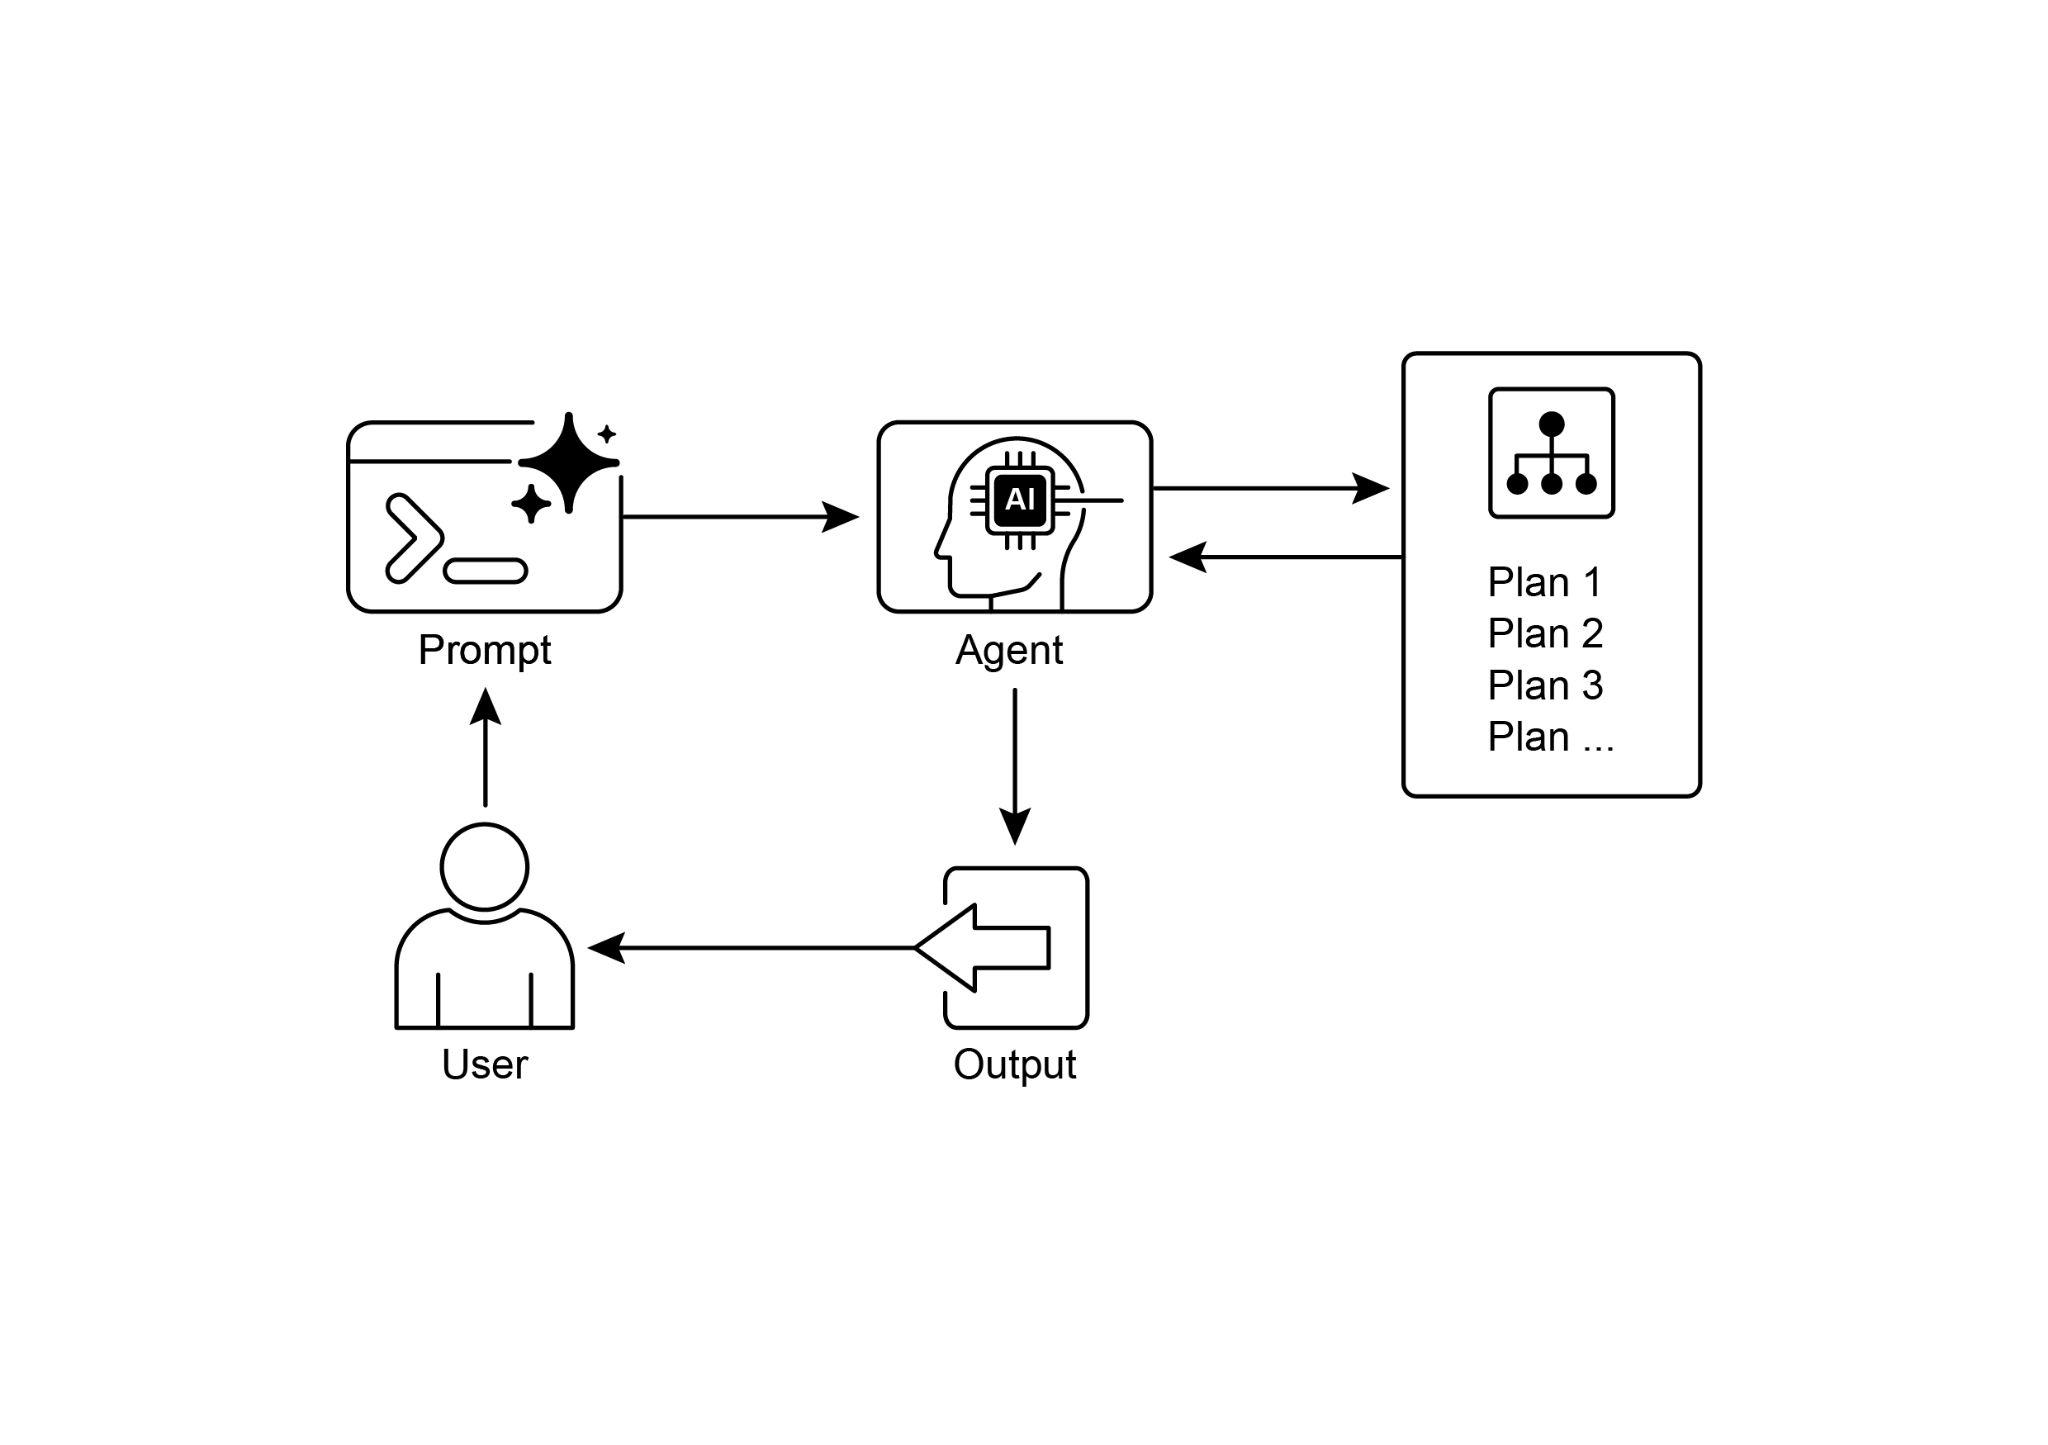
图 4:规划(Planning)设计模式。
要点
- 规划使智能体能够把复杂目标拆成可依次执行的步骤。
- 它对多步任务、工作流自动化以及复杂环境中的决策都至关重要。
- LLM 可以根据任务描述生成逐步方案,从而承担规划工作。
- 在提示或任务设计中显式加入规划环节,有助于强化这种行为。
- Google Deep Research 就是一个典型例子:它以 Google 搜索为工具,具备反思、规划和执行能力。
结语
总之,规划模式是智能体系统的基础构件之一。它把系统从简单的反应式应答者,提升为更具战略性和目标导向的执行者。现代大语言模型提供了将高层目标自主拆解为连贯、可执行步骤的核心能力。该模式既适用于 CrewAI 智能体这类顺序执行场景,也能扩展到更复杂、更动态的系统;Google DeepResearch 就是一个高阶例子,它能够在持续收集信息的过程中迭代研究计划并不断调整。归根结底,规划在复杂问题中架起了人类意图与自动执行之间的桥梁。借助结构化的问题求解路径,智能体得以管理复杂工作流,并交付完整、综合的结果。
参考资料
- Google DeepResearch(Gemini 功能):gemini.google.com
- OpenAI,Introducing deep research:https://openai.com/index/introducing-deep-research/
- Perplexity,Introducing Perplexity Deep Research:https://www.perplexity.ai/hub/blog/introducing-perplexity-deep-research